Acelerar la Entrega de Productos de Datos con un Agente de Ingesta

Un agente de ingesta basado en IA que convierte una conversación en pipelines de datos listos para producción, automatizando el perfilado de fuentes, la selección de estrategias, la generación de artefactos y la validación para cualquier fuente de datos.

El Cliente

Grupo global de (rea)seguros cotizado en bolsa y con sede en Estados Unidos, que opera en los ramos de daños, responsabilidad civil y seguros especializados. La organización suscribe riesgos complejos para multinacionales y clientes institucionales, con una sólida presencia en Norteamérica, Bermudas, Europa y Asia.

Como aseguradora internacional de gran escala que opera en el mercado de Lloyd's, la compañía está sujeta a estrictos requisitos de reporting regulatorio y financiero. Su presencia global, la complejidad de la suscripción y sus obligaciones de gestión de capital exigen altos niveles de gobierno, precisión y transparencia en la presentación de información regulatoria.
$18B+
Primas Brutas Suscritas
3000+
Empleados en Todo el Mundo
100+
Países en los que Opera
Support Image
Cta Image

El Reto

Los equipos de ingeniería de datos de la organización afrontaban una acumulación creciente de solicitudes de ingesta procedentes de múltiples sistemas de origen, plataformas Databricks externas, bases de datos SQL y zonas de aterrizaje basadas en archivos. Cada nueva fuente de datos exigía días de trabajo manual: perfilar esquemas, escribir plantillas SQL, configurar pipelines, generar DDL, registrar estrategias y validar resultados en las capas RAW y CLEAN.

Al no existir un framework estandarizado ni herramientas automatizadas, la calidad de los pipelines dependía por completo de la experiencia de cada ingeniero. Las convenciones de nomenclatura se desviaban, las estrategias de ingesta se aplicaban de forma incoherente y las pruebas solían omitirse ante la presión de las entregas. El resultado era un ecosistema creciente de pipelines frágiles y mal documentados que ralentizaban el desarrollo posterior de productos de datos.

La organización necesitaba industrializar la entrega de ingestas para que fuera rápida, repetible y con calidad garantizada, independientemente del nivel de experiencia del ingeniero.

Nuestra Solución
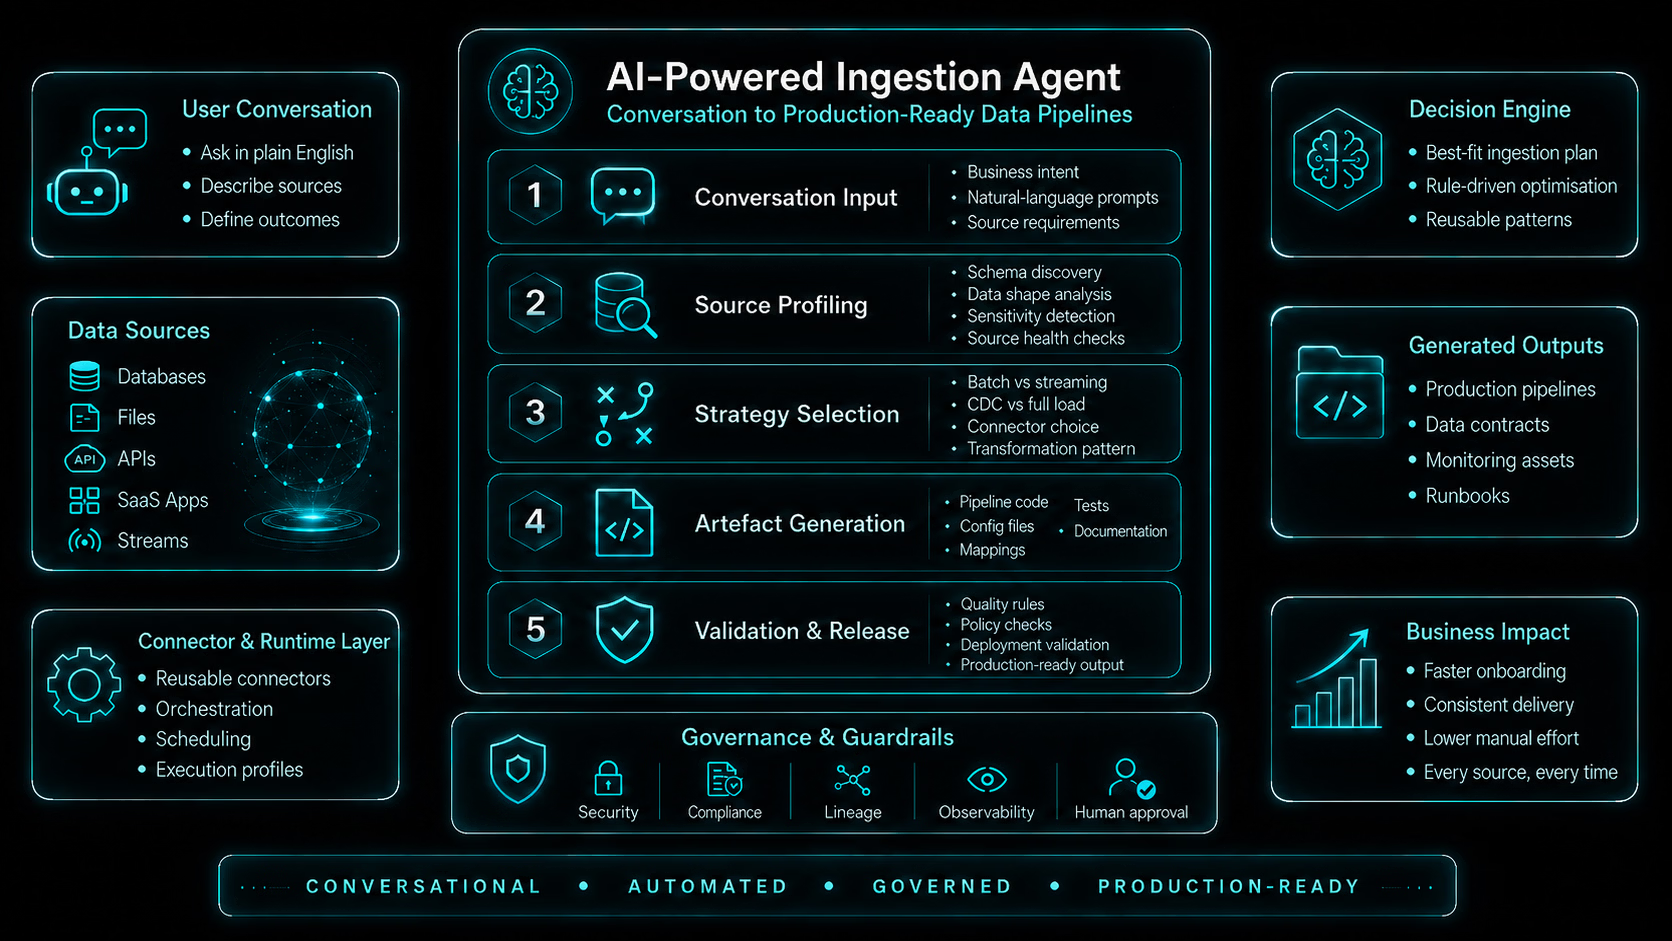
Diseñamos e implantamos un especialista de ingesta agéntico: un agente basado en IA que guía a los ingenieros por todo el flujo de ingesta mediante lenguaje natural, desde el perfilado de la fuente hasta la generación de código validado y listo para producción.
Captura Conversacional de Requisitos
Los ingenieros describen la fuente en lenguaje natural. El agente formula preguntas específicas para determinar el tipo de fuente, el modo de ingesta, la estrategia de particionado y el enfoque de limpieza, garantizando que se recopilen todos los parámetros necesarios antes de generar una sola línea de código. No se requieren conocimientos especializados de la plataforma subyacente.
Perfilado Automatizado de Fuentes y Recomendación de Estrategia
El agente perfila de forma autónoma la tabla de origen, analizando el esquema, el número de filas, el volumen de datos, las columnas de marca de agua y los patrones de cambio. Clasifica los datos como Referencia, Dimensión o Hecho y recomienda el modo óptimo de ingesta RAW —incremental o carga completa— y la estrategia de la capa CLEAN —fusión SCD tipo 2, histórico de snapshots o sustitución completa— con un razonamiento claro y adaptado al contexto.
Generación de Artefactos sin Código
A partir de una configuración confirmada, el agente genera de forma autónoma los 10 artefactos necesarios del pipeline: plantillas SQL, clases de estrategia, pipelines de ingesta y limpieza, DDL de RAW y CLEAN, registro en la factoría y actualizaciones del workflow. No se requiere programación manual: el stack completo de ingesta se produce en segundos, de forma coherente y conforme a los estándares.
Control de Calidad con Supervisión Humana
Antes de generar cualquier artefacto, el agente presenta un resumen completo de la configuración para su revisión y aprobación explícita. Los ingenieros verifican el modo de ingesta, la estrategia de particionado, las claves de negocio y el enfoque de la capa CLEAN, combinando la velocidad de la generación mediante IA con la confianza de la supervisión experta. No se produce código sin la aprobación de una persona.
Validación Automatizada en Dos Ejecuciones
El agente ejecuta dos ciclos completos de ingesta por conjunto de datos y valida ambos con herramientas automatizadas, comprobando el número de filas, la estructura de particiones, la integridad de las columnas SCD y el comportamiento específico de la estrategia. La primera ejecución establece la referencia; la segunda confirma que la estrategia funciona correctamente en condiciones reales. No se confirma código hasta que ambas ejecuciones se completan correctamente.
Gobierno y Observabilidad
Cada pipeline generado por el agente ofrece linaje de datos de extremo a extremo, métricas de calidad y resúmenes de conciliación mediante la integración con Unity Catalog y Azure Monitor. Los responsables de productos de datos y los equipos de plataforma obtienen visibilidad completa sobre la salud y fiabilidad del ecosistema de datos, facilitando la auditabilidad y la detección proactiva de incidencias en todos los dominios.
Agentic AI data ingestion workflow

El Valor Aportado

La plataforma de ingeniería de datos agéntica transformó la capacidad de la organización para entregar productos de datos fiables a escala: redujo la entrega de ingestas de una jornada completa de trabajo manual a menos de 10 minutos, con controles de calidad integrados y alineación automática con los dominios.
Entrega de Pipelines Más Rápida
144x
Lo que requería una jornada completa de ingeniería manual ahora se completa en menos de 10 minutos. Cincuenta nuevas fuentes de datos, que antes exigían 50 días de incorporación, se entregan ahora en un solo día.
Reducción de Incidencias de Calidad del Dato
95%
La conciliación integrada y los controles de calidad automatizados eliminaron el 95 % de las incidencias de datos que antes detectaban los consumidores posteriores, restaurando la confianza en todo el ecosistema.
Capacidad de Ingeniería Liberada
70%
El 70 % del tiempo de ingeniería que antes se dedicaba a programar pipelines manualmente se reasignó a la responsabilidad sobre productos de datos, el diseño de dominios y las iniciativas estratégicas de datos.
Interfaz de Requisitos en Lenguaje Natural
El agente guía a los desarrolladores durante la captura de requisitos íntegramente en lenguaje natural y formula preguntas específicas para obtener las estrategias de ingesta, las reglas de negocio, los umbrales de calidad y el contexto del dominio, garantizando que no se omita nada antes de generar una sola línea de código.
Entrega sin Código con Supervisión Humana
Los desarrolladores definen los requisitos y el agente escribe todo el código. Cada pipeline generado se valida automáticamente frente a los estándares de ingeniería antes de presentarse a una persona para su aprobación final, combinando la velocidad de la generación mediante IA con la confianza de la supervisión experta.
Ingenieros Convertidos en Responsables de Productos de Datos
Al encargarse el agente de generar todos los pipelines, los ingenieros de datos quedan liberados por completo de la programación manual y pasan a responsabilizarse de los productos de datos, definir los requisitos de dominio y verificar los resultados del agente.